
Última revisión documental: 24 de agosto de 2026. Prueba en vivo: 5 de agosto de 2026. Ejecutamos siete escenarios contra el endpoint oficial de Chat Completions con deepseek-v4-flash y Thinking desactivado: dos pruebas de streaming, dos conversaciones de varias rondas, dos flujos de tool calling y una solicitud con una clave deliberadamente inválida. Los siete escenarios cumplieron los criterios definidos. Las cifras de latencia y coste describen esa sesión concreta; no son una garantía de rendimiento.
Actualización documental: 23 de agosto de 2026. El catálogo y las tarifas actuales se muestran en bloques separados. No se ejecutó una nueva solicitud para esta guía y no se atribuyen los resultados del 5 de agosto a Pro-0813 ni a Vision Exp.
Un chatbot útil no es solo un cuadro de texto conectado a un modelo. Necesita una interfaz, un servidor que proteja la clave, gestión del historial, límites de uso, controles de seguridad y una forma de observar errores y costes. En esta guía construiremos una base funcional con Node.js, Express y la API compatible con OpenAI de DeepSeek. El navegador hablará únicamente con nuestro servidor; la clave nunca llegará al JavaScript público.
El ejemplo admite conversaciones de varias rondas, selección explícita entre DeepSeek-V4-Flash y DeepSeek-V4-Pro, respuestas en streaming, validación básica y un límite de historial. Continúa siendo un ejemplo de texto. Integrar Vision Exp exige construir mensajes multimodales y validaciones de imágenes; no se añadió ese flujo al código ni se afirma haberlo probado. Después añadiremos un ejemplo completo de tool calling para distinguir entre la función que propone el modelo y la operación que ejecuta el servidor.
DeepSeek-Español.chat es un sitio independiente y no está afiliado, autorizado ni respaldado por DeepSeek. Este tutorial describe una integración de terceros que utiliza la API de DeepSeek; no es documentación oficial ni una aplicación oficial de DeepSeek.
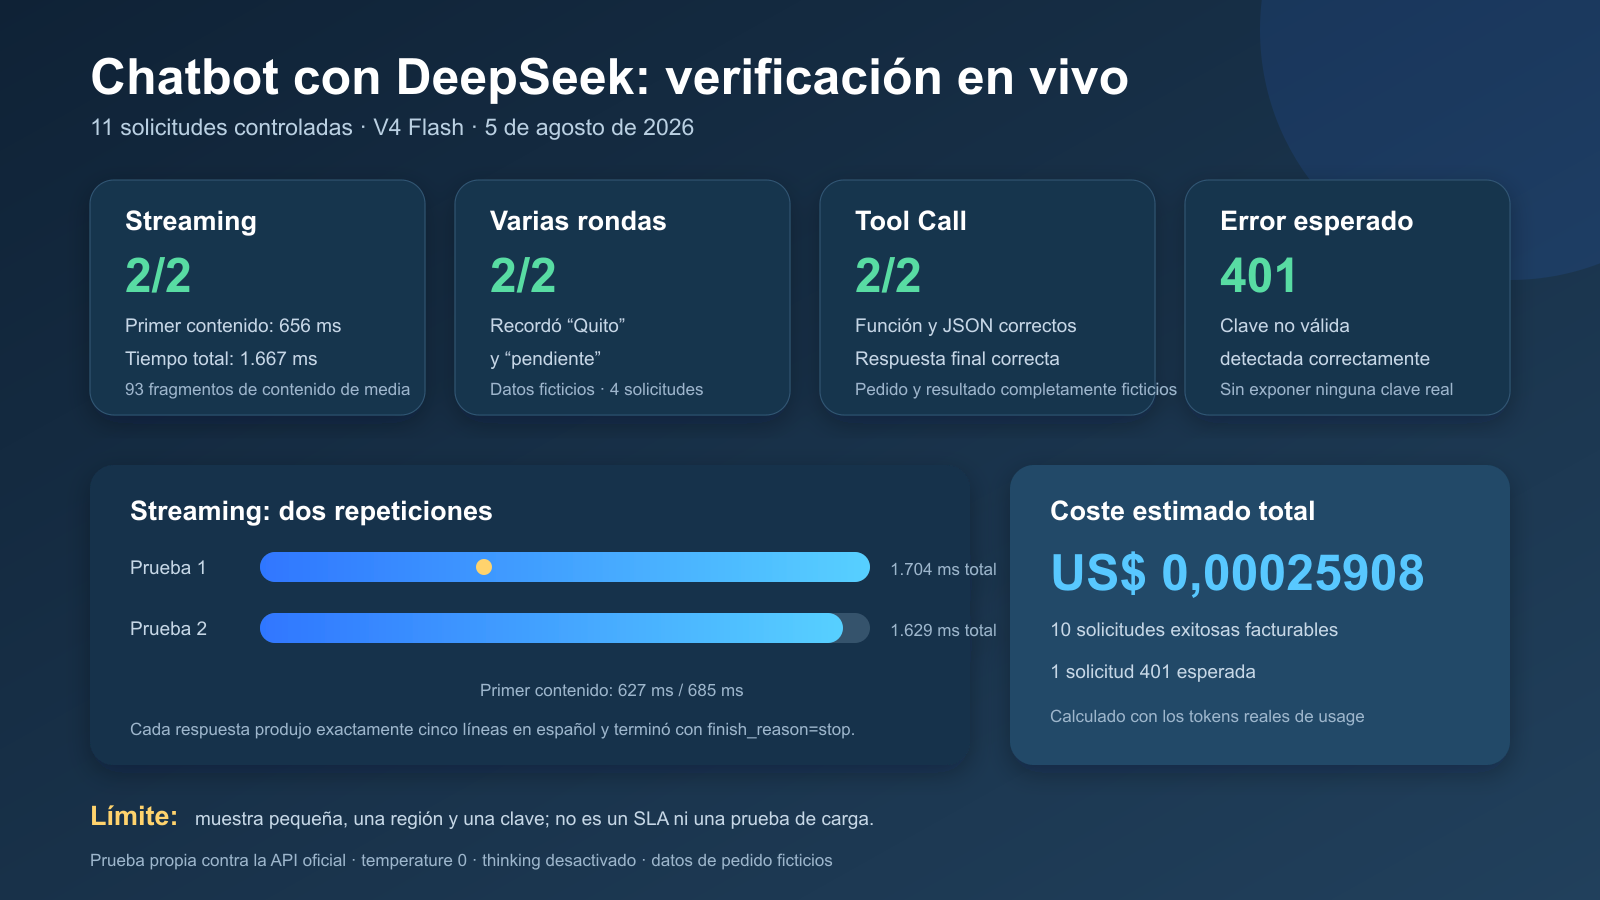
Resultados de las pruebas en vivo
| Escenario | Muestra | Resultado observado | Uso y coste estimado |
|---|---|---|---|
| Streaming | 2 réplicas | HTTP 200 y finish_reason: stop en ambas. Primer contenido a 627,3 y 685,4 ms; respuesta completa a 1.704,2 y 1.629,2 ms. |
143 y 139 tokens; 0,00003332 y 0,00003220 USD. |
| Conversación de dos rondas | 2 réplicas, 4 solicitudes | Las cuatro solicitudes devolvieron HTTP 200. Al reenviar el historial, la segunda respuesta conservó correctamente los datos ficticios Quito | pendiente. |
158 tokens y 0,00002338 USD por conversación completa. |
| Tool calling | 2 réplicas, 4 solicitudes | Primera respuesta con tool_calls, argumentos validados para PED-2048 y respuesta final correcta después de añadir el resultado de la herramienta. |
915 tokens por flujo; 0,00009096 y 0,00005584 USD, con distinta proporción de caché. |
| Clave inválida | 1 solicitud | HTTP 401 y tipo authentication_error en 278,2 ms. Se usó una cadena falsa creada solo para la prueba. |
Sin contenido generado. |
En streaming, el tiempo medio hasta el primer fragmento fue de 656,4 ms y el tiempo total medio fue de 1.666,7 ms. En ambas réplicas la respuesta produjo exactamente las cinco líneas numeradas solicitadas y el fragmento final incluyó el campo usage.
Metodología y límites de la prueba
- Fecha y endpoint: 5 de agosto de 2026,
https://api.deepseek.com/chat/completions. - Configuración:
deepseek-v4-flashythinking: disabled. Los escenarios exitosos usarontemperature: 0;max_tokensfue 160 en streaming, 32 por ronda y 96 por llamada de herramienta. En streaming se activóstream_options.include_usage. - Repetición: streaming, multi-turn y tool calling se ejecutaron dos veces; la respuesta 401 se comprobó una vez.
- Criterios: códigos HTTP esperados, motivo de finalización, estructura solicitada, continuidad de datos y nombre y argumentos de la herramienta.
- Coste: estimación calculada con los tokens devueltos por la API y las tarifas base de Flash verificadas ese día. No es una cifra de factura. El futuro multiplicador de hora punta anunciado por DeepSeek no se aplicó porque la documentación todavía no indicaba una fecha efectiva.
- Datos: se conservaron resultados brutos sanitizados; no contienen la clave válida.
Lo que esta prueba no demuestra: no es una prueba de carga, no compara regiones ni modelos, no mide DeepSeek-V4-Pro, no provoca errores 402, 429, 500 o 503 y no valida una interfaz de producción. El ejemplo de pedido no consultó un CRM real: el harness validó la llamada propuesta por el modelo e introdujo una respuesta local determinista. Por eso estas cifras sirven para reproducir el flujo, no para prometer una latencia universal ni una integración empresarial ya desplegada.
Qué ofrece la API oficial el 23 de agosto de 2026
La familia alojada actual incluye deepseek-v4-flash (DeepSeek-V4-Flash-0731), deepseek-v4-pro (DeepSeek-V4-Pro-0813, GA desde el 13 de agosto) y deepseek-v4-flash-vision-exp (experimental desde el 21 de agosto). Los tres ofrecen 1M de contexto, hasta 384K de salida, JSON, Tool Calls, Responses y Anthropic.
| Modelo | Entrada | Salida | Uso en esta guía |
|---|---|---|---|
deepseek-v4-flash |
Texto | Texto | Probado el 5 de agosto con Thinking desactivado |
deepseek-v4-pro |
Texto | Texto | Compatible con el patrón, pero no probado aquí |
deepseek-v4-flash-vision-exp |
Texto e imágenes | Texto | Requiere mensajes multimodales; no probado aquí |
Vision Exp no genera imágenes ni audio. PDF y otros documentos no están admitidos como tipo document; procesa el contenido antes o envía imágenes de páginas con límites de tamaño, derechos y privacidad. Las imágenes se facturan como tokens de entrada. Los niveles nativos de razonamiento actuales son low, high y max.
Consulta la ficha de DeepSeek V4 y la guía de errores de la API. El tutorial mantiene Flash y Pro porque su esquema de entrada es textual; no añadas el ID de Vision al selector sin implementar y probar el cuerpo multimodal.
Precios actuales, separados de la prueba histórica
Estas tarifas están verificadas el 23 de agosto de 2026 y no se usan para recalcular los resultados del test del 5 de agosto.
| Modelo | Periodo | Entrada con cache hit | Entrada con cache miss | Salida |
|---|---|---|---|---|
| Flash | Off-peak | 0,007 USD | 0,22 USD | 0,66 USD |
| Flash | Peak | 0,014 USD | 0,44 USD | 1,32 USD |
| Pro | Off-peak | 0,022 USD | 0,66 USD | 1,98 USD |
| Pro | Peak | 0,044 USD | 1,32 USD | 3,96 USD |
| Vision Exp | Off-peak | 0,007 USD | 0,22 USD | 0,66 USD |
| Vision Exp | Peak | 0,014 USD | 0,44 USD | 1,32 USD |
Peak se aplica en días laborables de 01:00 a 04:00 y de 06:00 a 10:00 UTC. El resto es off-peak; desde el 23 de agosto, sábado y domingo según la hora de Pekín aplican off-peak todo el día. Las imágenes de Vision Exp se facturan como tokens de entrada. Consulta la calculadora de precios antes de presupuestar.
Arquitectura mínima y segura
- Navegador: envía el mensaje y muestra fragmentos de la respuesta.
- Servidor propio: autentica al usuario, valida el cuerpo, añade instrucciones y llama a DeepSeek.
- Almacenamiento opcional: guarda conversaciones solo si existe una necesidad y una política de retención claras.
- Proveedor del modelo: procesa el prompt y devuelve texto o una solicitud de herramienta.
Esta separación evita exponer la clave API y permite aplicar cuotas por usuario. Una aplicación totalmente estática no puede guardar de forma segura una clave compartida. Ofrecer un campo para que cada visitante introduzca su propia clave es otro producto, con riesgos de phishing y soporte distintos; no lo mezcles con este diseño.
1. Preparar el proyecto
Necesitas Node.js 20 o posterior y una clave creada en la plataforma oficial. Instala Express, el SDK de OpenAI, validación con Zod y variables de entorno:
mkdir deepseek-chatbot
cd deepseek-chatbot
npm init -y
npm install express openai zod dotenv helmet express-rate-limit
npm pkg set type=module
Crea una variable DEEPSEEK_API_KEY en el entorno del servidor. No la escribas en el repositorio, en una plantilla HTML ni en una variable cuyo nombre empiece por VITE_, NEXT_PUBLIC_ o equivalente. Añade el archivo local de secretos a .gitignore y configura el secreto mediante el panel de tu proveedor al desplegar.
DEEPSEEK_API_KEY=tu_clave_del_servidor
PORT=3000
2. Crear un endpoint de chat
El siguiente servidor acepta como máximo 24 mensajes, limita cada contenido a 8.000 caracteres y restringe el modelo a una lista permitida. Estos límites no sustituyen el cálculo real de tokens, pero evitan cuerpos arbitrariamente grandes. En producción, autentica antes de consumir una cuota pagada.
import "dotenv/config";
import express from "express";
import helmet from "helmet";
import rateLimit from "express-rate-limit";
import OpenAI from "openai";
import { z } from "zod";

if (!process.env.DEEPSEEK_API_KEY) {
  throw new Error("Falta DEEPSEEK_API_KEY");
}

const app = express();
app.use(helmet());
app.use(express.json({ limit: "128kb" }));
app.use("/api/", rateLimit({ windowMs: 60_000, limit: 30 }));

const client = new OpenAI({
  apiKey: process.env.DEEPSEEK_API_KEY,
  baseURL: "https://api.deepseek.com"
});

const messageSchema = z.object({
  role: z.enum(["user", "assistant"]),
  content: z.string().min(1).max(8_000)
});

const requestSchema = z.object({
  model: z.enum(["deepseek-v4-flash", "deepseek-v4-pro"])
    .default("deepseek-v4-flash"),
  messages: z.array(messageSchema).min(1).max(24)
});

app.post("/api/chat", async (req, res) => {
  const parsed = requestSchema.safeParse(req.body);
  if (!parsed.success) {
    return res.status(400).json({ error: "Solicitud no válida" });
  }

  try {
    const completion = await client.chat.completions.create({
      model: parsed.data.model,
      messages: [
        { role: "system", content: "Responde en español con claridad. Si no sabes algo, dilo." },
        ...parsed.data.messages
      ],
      thinking: { type: "disabled" },
      max_tokens: 800,
      stream: false
    });

    return res.json({
      answer: completion.choices[0]?.message?.content ?? "",
      usage: completion.usage ?? null
    });
  } catch (error) {
    console.error("DeepSeek request failed", error?.status ?? error?.message);
    return res.status(502).json({ error: "El proveedor no respondió correctamente" });
  }
});

app.listen(process.env.PORT || 3000);
Desactivamos Thinking para un chat rápido. Para tareas complejas puedes enviar thinking: { type: "enabled" } y reasoning_effort: "high" o "max". Los parámetros temperature y top_p pueden utilizarse en Non-Thinking, pero se ignoran cuando Thinking está habilitado. En cambio, presence_penalty y frequency_penalty están obsoletos en la API actual y no producen efecto en ningún modo. No construyas una función de producto ni controles de interfaz basados en parámetros que el modo o la API ignoran.
3. Añadir streaming sin revelar secretos
Para reducir la espera percibida, el servidor puede reenviar fragmentos como texto plano. El ejemplo añade el mismo prompt de sistema que el endpoint normal y solicita el fragmento final de uso mediante stream_options.include_usage. La clave permanece en el backend y la petición se cancela si el navegador cierra la conexión:
app.post("/api/chat/stream", async (req, res) => {
  const parsed = requestSchema.safeParse(req.body);
  if (!parsed.success) return res.status(400).end("Solicitud no válida");

  res.setHeader("Content-Type", "text/plain; charset=utf-8");
  res.setHeader("Cache-Control", "no-cache, no-transform");

  const controller = new AbortController();
  res.on("close", () => {
    if (!res.writableEnded) controller.abort();
  });

  try {
    const stream = await client.chat.completions.create({
      model: parsed.data.model,
      messages: [
        { role: "system", content: "Responde en español con claridad. Si no sabes algo, dilo." },
        ...parsed.data.messages
      ],
      thinking: { type: "disabled" },
      max_tokens: 800,
      stream: true,
      stream_options: { include_usage: true }
    }, { signal: controller.signal });

    let finalUsage = null;

    for await (const part of stream) {
      if (part.usage) finalUsage = part.usage;

      const text = part.choices[0]?.delta?.content;
      if (text && !res.writableEnded) res.write(text);
    }

    if (finalUsage) {
      console.info("deepseek_usage", {
        promptTokens: finalUsage.prompt_tokens,
        completionTokens: finalUsage.completion_tokens,
        totalTokens: finalUsage.total_tokens
      });
    }

    if (!res.writableEnded) res.end();
  } catch (error) {
    console.error("DeepSeek streaming failed", error?.status ?? error?.message);
    if (!res.headersSent) res.status(502);
    if (!res.writableEnded) res.end();
  }
});
El fragmento de uso no contiene texto y su lista choices está vacía, por eso se procesa part.usage antes de intentar leer el contenido. Este endpoint entrega texto plano y registra los tokens en el servidor. Si el frontend también debe recibir el uso, emplea SSE o NDJSON con eventos separados; no añadas JSON sin marcar al final de la respuesta visible.
En el frontend, usa fetch, comprueba response.ok y lee response.body con un lector. Renderiza el contenido como texto por defecto. Si conviertes Markdown en HTML, sanitiza el resultado con una biblioteca mantenida; insertar directamente HTML generado por un modelo abre la puerta a XSS.
4. Gestionar el historial sin desbordar el contexto
El endpoint es sin estado: el cliente debe enviar las rondas necesarias en cada solicitud. La prueba en vivo lo confirmó al añadir la respuesta de la primera ronda y la segunda pregunta al mismo array messages. En las dos réplicas, el modelo recuperó exactamente la ciudad y el estado ficticios dados antes: Quito | pendiente.
Un contexto de un millón de tokens no significa que debas reenviar todo indefinidamente. Más entrada aumenta coste, latencia y exposición de datos. Mantén las últimas rondas relevantes, resume conversaciones largas en el servidor y conserva hechos estructurados por separado.
- No confíes únicamente en caracteres; usa el campo
usagepara observar tokens reales. - No mezcles conversaciones de usuarios diferentes ni reutilices un identificador compartido.
- Si envías
user_id, usa un identificador opaco, sin correo, teléfono o nombre. - Define una caducidad para cualquier historial persistente y permite borrarlo.
- Evita guardar el razonamiento interno salvo que exista una necesidad legítima y documentada.
5. Implementar tool calling correctamente
DeepSeek puede devolver el nombre y los argumentos de una función, pero no ejecuta esa función. Tu servidor debe validar los argumentos, comprobar permisos, ejecutar una operación permitida y devolver el resultado como mensaje tool. Nunca conviertas cualquier nombre sugerido por el modelo en una llamada dinámica al sistema.
Este ejemplo es autocontenido respecto al flujo de tool calling. Utiliza una ficha local ficticia para que pueda reproducirse sin acceder a pedidos reales. En producción, sustituye consultarPedidoDePrueba por una consulta autorizada que reciba la identidad autenticada y compruebe que el pedido pertenece a ese usuario.
const tools = [{
  type: "function",
  function: {
    name: "consultar_estado_pedido",
    description: "Consulta el estado de un pedido permitido",
    parameters: {
      type: "object",
      properties: {
        pedidoId: { type: "string", pattern: "^[A-Z0-9-]{6,24}$" }
      },
      required: ["pedidoId"],
      additionalProperties: false
    }
  }
}];

const toolArgsSchema = z.object({
  pedidoId: z.string().regex(/^[A-Z0-9-]{6,24}$/)
});

async function consultarPedidoDePrueba(pedidoId) {
  if (pedidoId !== "PED-2048") throw new Error("Pedido de prueba no encontrado");

  return {
    pedidoId: "PED-2048",
    estado: "en tránsito",
    fecha_estimada: "2026-08-09"
  };
}

async function responderConEstadoPedido(pregunta) {
  const messages = [
    {
      role: "system",
      content: "Usa la herramienta para consultar pedidos. No inventes estados ni fechas."
    },
    { role: "user", content: pregunta }
  ];

  const first = await client.chat.completions.create({
    model: "deepseek-v4-flash",
    messages,
    tools,
    tool_choice: "auto",
    thinking: { type: "disabled" }
  });

  const assistantMessage = first.choices[0]?.message;
  const call = assistantMessage?.tool_calls?.[0];

  if (!call) return assistantMessage?.content ?? "";
  if (call.function.name !== "consultar_estado_pedido") {
    throw new Error("Herramienta no permitida");
  }

  const rawArgs = JSON.parse(call.function.arguments);
  const args = toolArgsSchema.parse(rawArgs);
  const result = await consultarPedidoDePrueba(args.pedidoId);

  messages.push(assistantMessage);
  messages.push({
    role: "tool",
    tool_call_id: call.id,
    content: JSON.stringify(result)
  });

  const final = await client.chat.completions.create({
    model: "deepseek-v4-flash",
    messages,
    thinking: { type: "disabled" }
  });

  return final.choices[0]?.message?.content ?? "";
}

const answer = await responderConEstadoPedido(
  "¿Dónde está el pedido PED-2048?"
);
console.log(answer);
Importante si combina Thinking con herramientas: el ejemplo anterior mantiene thinking desactivado, igual que la prueba histórica del 5 de agosto de 2026. Si adapta el flujo para enviar tools con Thinking, conserve el mensaje completo del asistente, incluido reasoning_content, y reenvíelo en todas las solicitudes posteriores de la conversación, incluso cuando una ronda no produzca una tool_call. La documentación vigente indica que omitirlo puede devolver HTTP 400. Esta aclaración no modifica retrospectivamente los resultados ni los costes de la prueba histórica.
En las dos pruebas, la primera respuesta terminó con tool_calls, propuso consultar_estado_pedido con { "pedidoId": "PED-2048" } y la segunda terminó con stop. La respuesta final indicó “en tránsito” y el 9 de agosto de 2026 porque esos valores procedían de la ficha local; el modelo no los descubrió ni consultó un sistema externo.
Una operación de lectura también necesita autorización. Para cancelar pedidos, emitir reembolsos, enviar mensajes o modificar cuentas, exige confirmación humana y controles deterministas. El modelo no debe decidir por sí solo que una acción irreversible está autorizada. Si admites llamadas múltiples, valida y autoriza cada elemento de tool_calls, no solo el primero.
6. Privacidad, seguridad y moderación
Si tu chatbot usa la API, el prompt sale del navegador y se entrega al proveedor para generar una respuesta. Guardar el historial localmente no convierte el procesamiento en local. Explica el flujo en tu política de privacidad, identifica a los proveedores, documenta la base jurídica aplicable y evita pedir datos sensibles que el caso de uso no necesita.
- Autentica usuarios antes de permitir consumo significativo.
- Aplica límites por cuenta, IP y organización, no solo el límite global del proveedor.
- Elimina secretos, contraseñas y números completos de documentos antes del prompt.
- Registra métricas y códigos de error, no el contenido completo por defecto.
- Protege las herramientas contra prompt injection mediante listas permitidas y autorización en código.
- Informa de que la salida puede contener errores y facilita revisión humana en usos de impacto.
Consulta también nuestra política de privacidad, la página de seguridad y los términos del sitio. Esos documentos deben describir tu implementación real y no copiar afirmaciones de la aplicación oficial.
7. Controlar coste y calidad
Usa Flash para soporte frecuente, clasificación y conversación rápida; reserva Pro para problemas que realmente se beneficien de mayor capacidad. Esta es una decisión de producto, no una garantía universal de calidad. Mide respuestas aceptadas, escalados humanos, latencia, tokens de entrada y salida, aciertos de caché y errores por modelo.
Con las tarifas base de Flash del 5 de agosto, el coste medio estimado fue de 0,00003276 USD para una respuesta en streaming, 0,00002338 USD para la conversación completa de dos rondas y 0,00007340 USD para el flujo de herramienta con dos llamadas. La diferencia entre las dos réplicas de tool calling se debió a los tokens de entrada que la API marcó como cache hit: 384 en la primera y 640 en la segunda.
Estas cifras no predicen el coste de un chatbot real: los prompts, el historial, la longitud de salida, el modelo y la proporción de caché cambian el total. Define un presupuesto por sesión: máximo de rondas, máximo de tokens de salida y cuota diaria. Calcula el gasto con los campos reales de usage y la tarifa vigente. Nuestra página de precios de DeepSeek explica la diferencia entre caché y no caché, mientras que la guía de API reúne endpoints y parámetros.
8. Pruebas antes de publicar
En esta sesión se verificaron respuestas 200, streaming completo, continuidad de dos rondas, el ciclo de tool calling y un 401 real con una clave falsa. Antes de producción todavía debes cubrir los siguientes casos con tu propia aplicación y tu infraestructura:
- Solicitudes vacías, demasiado grandes y con roles no permitidos.
- Saldo insuficiente 402, límite 429, timeout, 500, 503 y respuestas interrumpidas.
- Ausencia de la clave en bundles, mapas de código, logs y respuestas.
- Conversaciones en español real, incluidas faltas ortográficas, ambigüedad y solicitudes fuera de alcance.
- Intentos de ignorar reglas, invocar herramientas inexistentes o acceder a recursos de otro usuario.
- Escalado humano, borrado del historial y respuesta segura cuando el modelo no sabe algo.
- Alertas por aumento de errores, latencia o gasto y pruebas de carga acordes con el tráfico esperado.
Un test que solo pregunta “hola” no valida un chatbot. Crea un conjunto de casos representativos con criterios objetivos, vuelve a ejecutarlo cuando cambie el modelo y conserva la versión de instrucciones evaluada. Las respuestas son probabilísticas; evita aserciones basadas en una frase exacta salvo en campos estructurados validados.
9. Diseñar una experiencia clara y recuperable
La interfaz debe distinguir entre “enviando”, “generando”, “completado” y “error”. Durante el streaming muestra un indicador visible y conserva el texto ya recibido, pero no presentes una respuesta cortada como terminada. Añade un botón de detener que cancele también la petición en el servidor; ocultar el texto en pantalla no detiene el consumo.
Permite copiar, volver a intentar y empezar una conversación nueva. Explica qué parte del historial se enviará y ofrece borrado. Para accesibilidad, anuncia las respuestas nuevas mediante una región adecuada, conserva el foco del teclado, no uses solo color para los estados y permite leer el contenido sin animaciones. Un chatbot eficaz debe seguir funcionando cuando el lector de pantalla o la conexión son lentos.
No muestres una cifra inventada de “confianza”. Es mejor presentar fuentes aportadas por el propio usuario, separar hechos de sugerencias y proporcionar un camino de escalado. En soporte, el traspaso humano debe incluir únicamente el contexto autorizado, el motivo del escalado y la respuesta incompleta, sin duplicar todo el historial por defecto.
10. Preparar operación e incidentes
Versiona el prompt de sistema y el esquema de herramientas. Despliega cambios a una fracción de usuarios, compara calidad, latencia y coste, y conserva una forma rápida de volver a la versión anterior. Configura un interruptor para desactivar herramientas o nuevas conversaciones sin borrar datos ni bloquear el acceso al historial existente.
Define quién responde ante una clave filtrada, un incremento de gasto, contenido peligroso o una caída del proveedor. El procedimiento debe cubrir rotación de secretos, pausa de tráfico, aviso interno, revisión de logs mínimos y comunicación honesta al usuario. Si cambias de modelo, vuelve a ejecutar las evaluaciones: compartir una interfaz de API no garantiza respuestas equivalentes.
Preguntas frecuentes
¿Puedo llamar a DeepSeek directamente desde el navegador?
No con una clave compartida. Cualquier secreto incluido en JavaScript público puede extraerse y utilizarse a tu cargo. Realiza la llamada desde un servidor o una función backend.
¿Debo usar deepseek-chat o deepseek-reasoner?
No. Usa IDs V4 explícitos: deepseek-v4-flash o deepseek-v4-pro para texto, y deepseek-v4-flash-vision-exp solo si implementas entradas de imágenes. Declara Thinking de forma explícita.
¿La API acepta imágenes?
Sí, pero solo con el modelo experimental deepseek-v4-flash-vision-exp. Recibe texto e imágenes y responde con texto; no genera imágenes ni audio. PDF y otros documentos no se aceptan como tipo document, y las imágenes se facturan como tokens de entrada. El chatbot de esta guía no implementa ni prueba ese flujo.
¿Tool calling significa navegación web automática?
No. Una Tool Call solo solicita una función que el cliente o el servidor debe proporcionar, autorizar y ejecutar. El ejemplo de esta guía utiliza Chat Completions y una herramienta local ficticia; por sí solo no navega por Internet.
Para añadir búsqueda, puede implementar una herramienta autorizada en su backend o utilizar web_search mediante Responses API, que DeepSeek ejecuta en el servidor. En ambos casos, limite el alcance, valide los resultados y controle tokens y gasto. Esta guía no probó ninguna de las dos rutas de búsqueda.
¿Un millón de tokens elimina la necesidad de resumir?
No. Un contexto grande sigue teniendo coste, latencia y riesgos de privacidad. Conserva únicamente lo necesario para la tarea y prueba la calidad de tus resúmenes.
Fuentes oficiales
- Inicio rápido de la API de DeepSeek
- Referencia oficial de Chat Completions
- Modelos y precios oficiales
- Límites y concurrencia
- Códigos de error oficiales
- Conversación de varias rondas
- Guía oficial de Thinking Mode
- Guía oficial de Tool Calls
- Guía oficial de Responses API y
web_search - Caché de contexto
- Anuncio oficial de V4 y retirada de alias
- Términos de DeepSeek Open Platform
- Política de privacidad oficial
- Guía oficial de Vision